推出 Galvanize 2:拦截更多攻击,误报大幅减少
更新(10 月 12 日):Galvanize 2 现已在 zn 云端检测中上线。
提示注入检测器有两项职责:既要拦截攻击,也要对其他一切内容保持克制。对于 AI 智能体而言,后一项职责与前一项同样重要。智能体整天都在阅读长文档、README、日志和工具输出。如果检测器把一份合法文档标记为威胁,智能体就会在真实工作的中途停下来。几次这样的中断之后,用户就会把它关掉,而关掉之后它就什么也拦不住了。
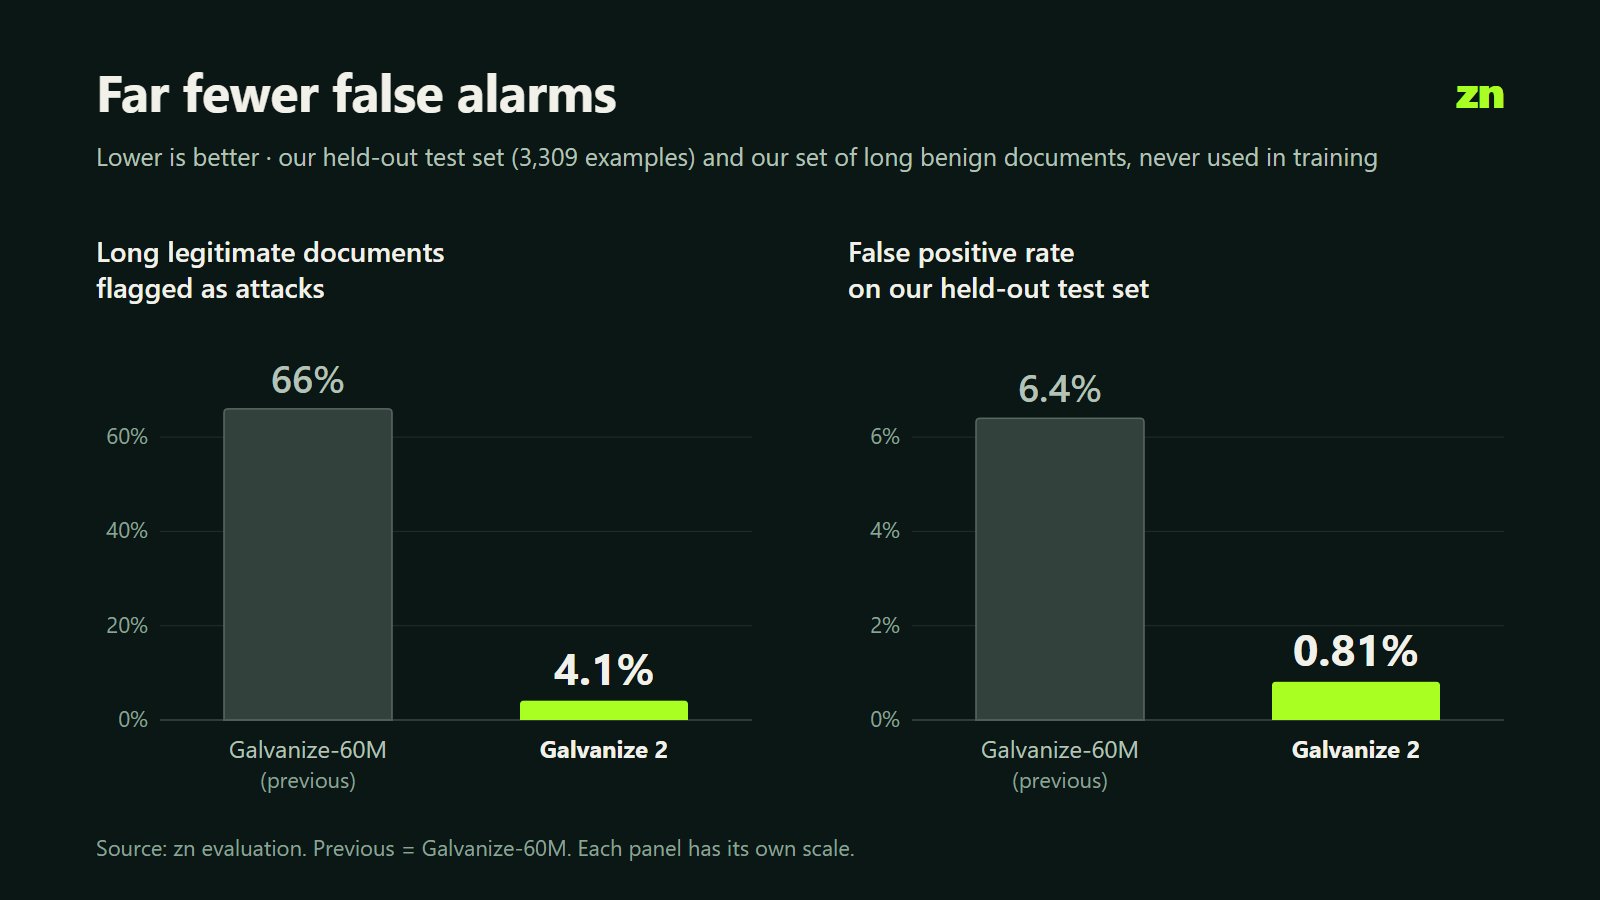
我们之前的模型 Galvanize-60M 没能通过这项测试。在我们的长篇良性文档集上,它把大约 66% 的文档标记为攻击。Galvanize 2 的这一比例是 4.1%,同时它拦截的攻击也比被替换的模型更多。
本文将介绍有哪些变化、结果(包括模型较弱的地方)、我们的测量方法,以及这对使用 zn-gate 的用户意味着什么。
有哪些变化
Galvanize 2 基于 Horizon-Labs/prompt-injection-guard-small(Apache-2.0)微调而来,约有 1.41 亿参数,支持多语言。我们选择 Horizon 的模型作为起点,是因为它本身已是一个强大的开源检测器,误报率很低。我们用自己混合的公开与内部提示注入数据对它做了微调,重点针对 AI 编程智能体的实际输入。
感谢 Horizon Labs 公开发布该模型,以及其训练来源和评估套件。没有他们的工作,Galvanize 2 就不会存在。
Galvanize 2 采用相同的许可证 Apache-2.0 发布:https://huggingface.co/usezn/Galvanize-2 。
结果
我们的预留测试集
我们的预留测试集包含 3,309 条多种语言的样本,这些样本均未用于训练。在我们的服务阈值 0.662 下:
| Galvanize-60M(旧版) | Galvanize 2 | |
|---|---|---|
| 检出率(召回率) | 66.9% | 83.4% |
| 误报率 | 6.4% | 0.81% |
| AUROC | 0.899 | 0.993 |
| 被标记的长篇良性文档 | 约 66% | 4.1% |
新模型拦截了更多攻击,而误报数量约为旧模型的八分之一。
同一测试集上按语言划分的召回率:英语 88%,葡萄牙语 87%,俄语 83%,德语 82%,西班牙语 82%,意大利语 76%。
我们还用内部针对自家检测器生成的新攻击进行了测试。在 601 条全新样本(训练中从未出现过)上,Galvanize 2 的拦截率为 67.2%。这些攻击的生成目的就是绕过我们之前的模型,因此它在该集合上不到 3% 的得分是按构造预期的。更公平的参照是我们起始所用的模型:在相同误报率下,Horizon small 的拦截率为 65.6%。在这一集合中,德语是表现最弱的语言,约为 50%。
公开基准
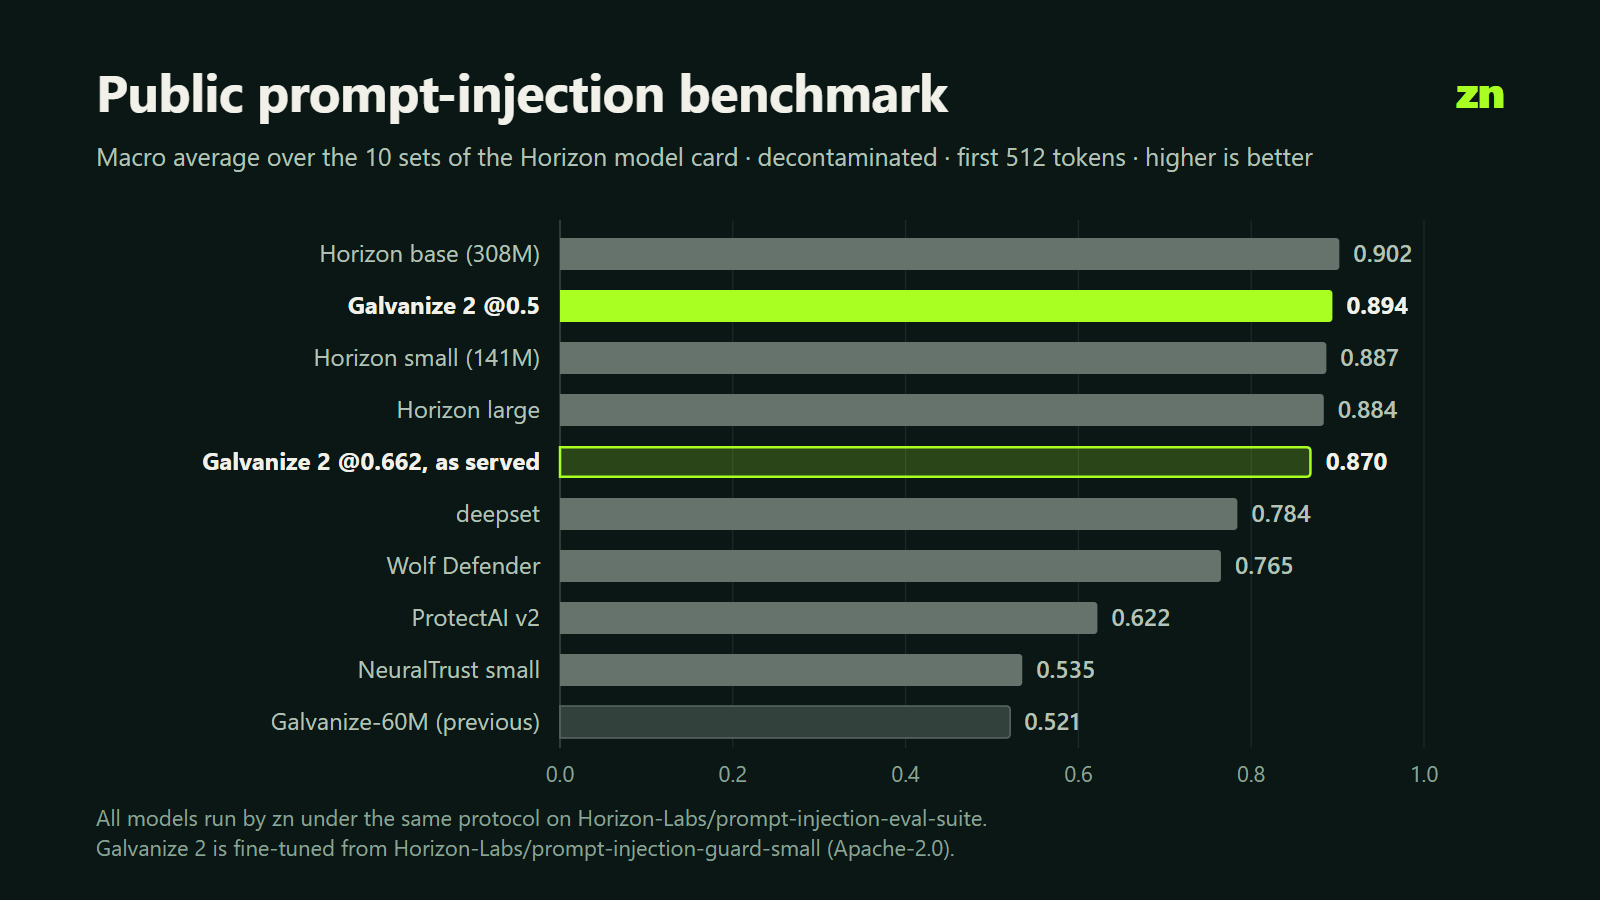
为了与其他开源检测器比较,我们在 Hugging Face 上运行了 Horizon-Labs/prompt-injection-eval-suite。我们报告的是 Horizon 模型卡所用 10 个数据集的宏平均值。每个模型都由我们在相同协议下自行运行(参见"我们如何测量")。
| 模型 | 宏平均 |
|---|---|
| Horizon base(3.08 亿) | 0.902 |
| Galvanize 2(阈值 0.5) | 0.894 |
| Horizon small(1.41 亿) | 0.887 |
| Horizon large | 0.884 |
| Galvanize 2(阈值 0.662,即线上服务配置) | 0.870 |
| deepset | 0.784 |
| Wolf Defender | 0.765 |
| ProtectAI v2 | 0.622 |
| NeuralTrust small | 0.535 |
| Galvanize-60M(旧版) | 0.521 |
在这一平均值上,Galvanize 2 并不是排名第一的模型:规模更大的 Horizon base 得分更高。它与我们测试过的最强开源检测器处于同一水平,并且较我们之前的模型有大幅提升。
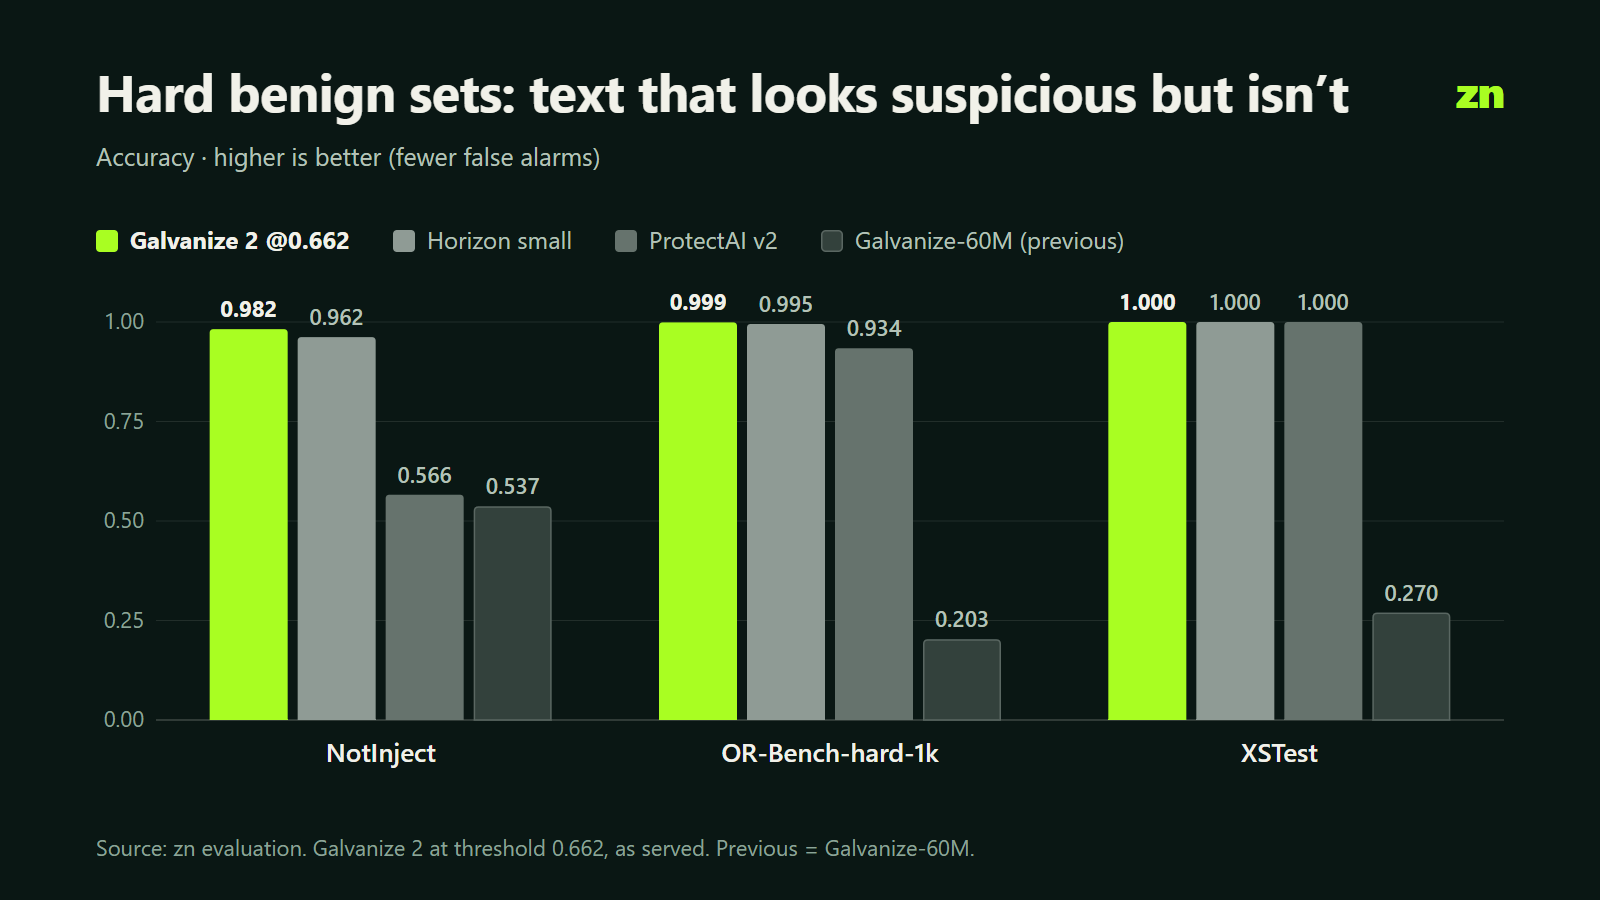
它最突出的成绩出现在高难度良性数据集上。这些数据包含看似可疑、实则并非攻击的文本:触发词,以及大胆但无害的请求。在阈值 0.662 下的准确率,数值越高表示误报越少:
| 数据集 | Galvanize-60M | Galvanize 2 |
|---|---|---|
| NotInject | 0.537 | 0.982 |
| OR-Bench-hard-1k | 0.203 | 0.999 |
| XSTest | 0.270 | 1.000 |
在 NotInject 和 OR-Bench-hard-1k 上,Galvanize 2 的得分是我们对比的所有检测器中最高的。
薄弱之处
在我们的服务阈值 0.662 下(括号内为 0.5 阈值的结果):
- deepset 测试集: F1 0.723(0.812)。deepset 自家模型在其自有测试集上得分为 0.992。
- BIPIA(隐藏在邮件、表格和代码中的注入):F1 0.601(0.670)。
- Simsonsun 越狱样本: 召回率 0.741(0.817)。
两个阈值之间的差距,一部分是我们有意做出的选择(下文说明),另一部分则是真实存在的:嵌入结构化内容中的注入,以及某些越狱风格,对模型来说仍然更难识别。
我们如何测量
去污染。 评分之前,我们删除了所有与训练数据在精确哈希、规范化文本哈希或前 200 个字符哈希上匹配的基准行。所有模型都在同一个去污染子集上评分。正因如此,以及下文所述的截断方式,我们对其他模型的数字会与其各自模型卡上的数字有所不同。
与生产环境相同的输入。 文本会被合并多余空白,并截断到前 512 个 token,与云端检测在服务时的处理完全一致。前 512 个 token 之后的内容不参与评分。
预留数据。 我们的预留测试集和长篇良性文档集从未用于训练。
两个阈值。 我们同时公布 0.5 和 0.662 的结果。我们线上使用 0.662,这是基于我们自己的开发数据校准的阈值。它牺牲了一部分召回率,以避免阻断合法用户,因为一次误报就会中断真实工作。如果你自行运行该模型,并且漏掉一次攻击的代价高于一次误报,请使用 0.5。
服务部署。 我们使用全精度模型。在一台 8 线程的服务器 CPU 上,每个请求的中位耗时约为 34 毫秒。
基准脚本与完整结果位于模型仓库中:https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark。
对 zn-gate 用户意味着什么
zn-gate 是面向 AI 编程智能体的开源本地安全层(npm install zn-gate 或 pip install zn-gate)。API 密钥、令牌和私钥等机密值会在你的机器上先被移除,然后才进行任何云端调用;工具输出永远不会被发送。可选的云端检测只在脱敏之后才接收提示文本。
Galvanize 2 今天已在 Hugging Face 上提供,并且现已成为 zn 云端检测(api.usezn.com)背后的默认模型。你无需做任何改动:如果你启用了云端检测,就会自动获得新模型。团队还可以获得可观测性以及每项决策的证据记录。目前提供免费套餐。
接下来
- 德语及其他较弱的语言。 在新攻击上,德语是表现最弱的语言,约为 50%,这也是我们首先着手改进的方向。
- 持续改进循环。 我们发现的每一个漏检,无论来自自己的测试还是用户反馈,都会成为下一版本的训练数据。
- 开放基准脚本,使任何人都能复现本文中的公开数字。
链接
- 模型与模型卡:https://huggingface.co/usezn/Galvanize-2
- 基础模型:Horizon-Labs/prompt-injection-guard-small
- 基准:Horizon-Labs/prompt-injection-eval-suite · 我们的脚本:https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark
- zn-gate:github.com/usezn/zn
如果你发现 Galvanize 2 在某个输入上判断错误(无论是漏报还是误报),请写信至 security@usezn.com。这些反馈正是下一版本训练所依据的内容。
— John Silver
2026 年 10 月 14 日更新:数据处理的表述已修改,以描述软件包和 API 当前的实际行为。