Presentamos Galvanize 2: más ataques detectados, muchas menos falsas alarmas
Actualización (12 oct): Galvanize 2 ya está activo en la comprobación en la nube de zn.
Un detector de inyección de prompts tiene dos tareas. Tiene que detectar ataques y tiene que dejar tranquilo todo lo demás. En un agente de IA, la segunda tarea importa tanto como la primera. Los agentes leen documentos largos, READMEs, registros y la salida de herramientas todo el día. Un detector que marca un documento legítimo detiene al agente en mitad de un trabajo real. Tras unas cuantas de esas paradas, la gente lo desactiva, y entonces ya no detecta nada.
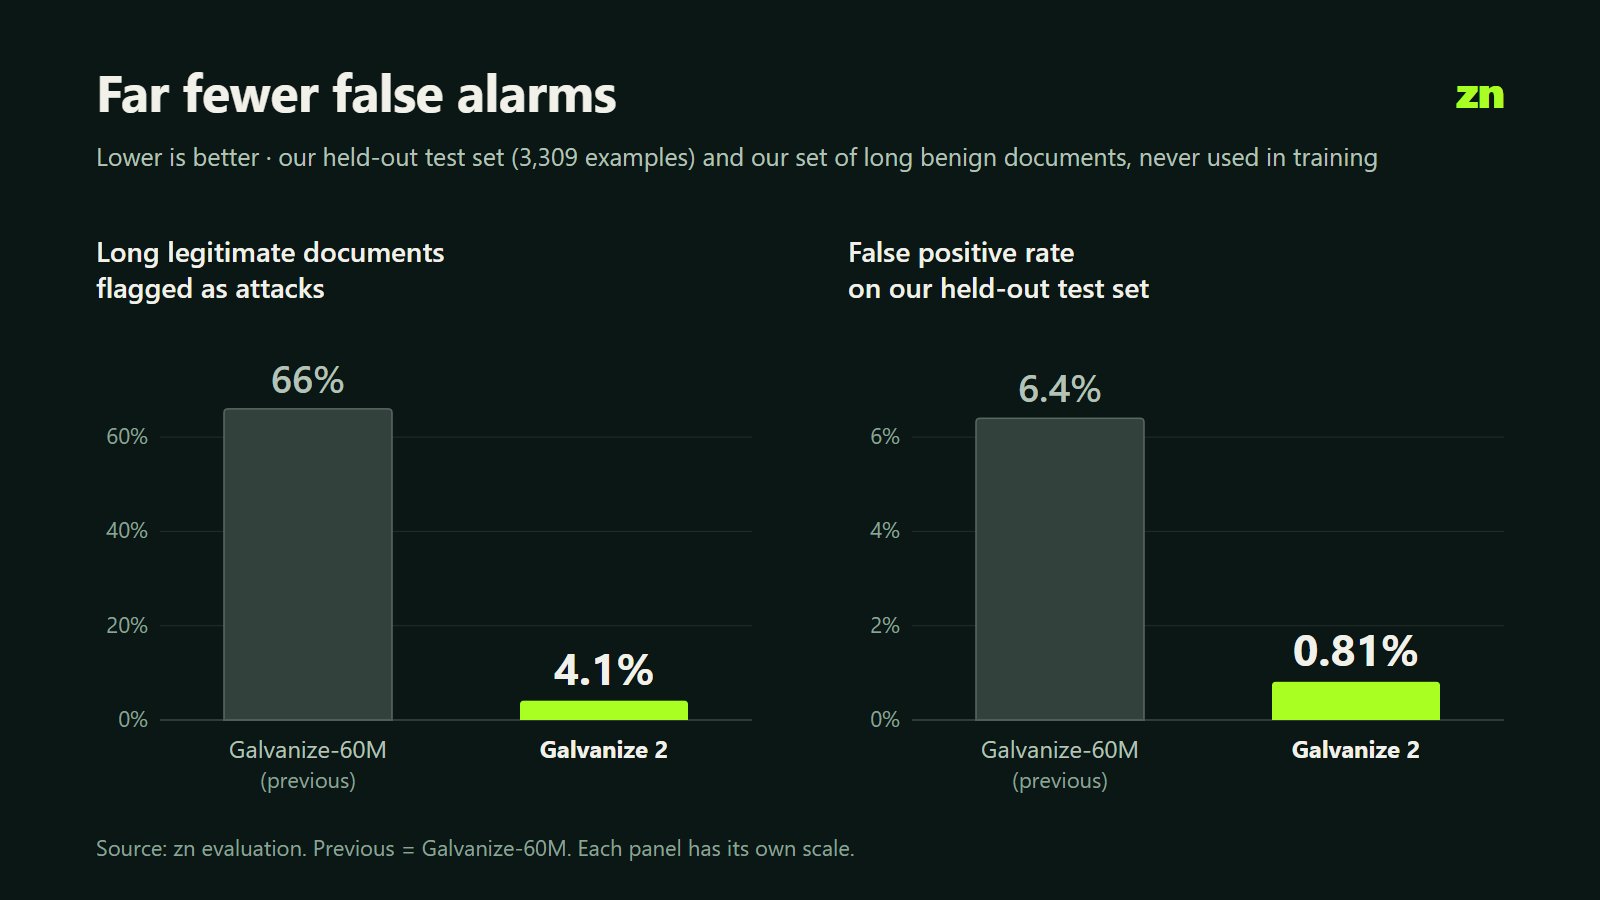
Nuestro modelo anterior, Galvanize-60M, no superó esa prueba. En nuestro conjunto de documentos largos benignos marcó como ataques alrededor del 66 %. Galvanize 2 marca el 4,1 %, y además detecta más ataques que el modelo al que sustituye.
Este artículo cubre qué cambió, los resultados (incluido dónde el modelo es más débil), cómo medimos y qué significa si usas zn-gate.
Qué cambió
Galvanize 2 se afina a partir de Horizon-Labs/prompt-injection-guard-small (Apache-2.0). Tiene unos 141 M de parámetros y es multilingüe. Partimos del modelo de Horizon porque ya es un detector abierto sólido con una tasa baja de falsas alarmas. Lo afinamos con nuestra propia mezcla de datos públicos e internos de inyección de prompts, orientada a lo que realmente ven los agentes de programación.
Gracias a Horizon Labs por publicar el modelo en abierto, con sus fuentes de entrenamiento y su suite de evaluación. Galvanize 2 no existiría sin ese trabajo.
Galvanize 2 se publica con la misma licencia, Apache-2.0: https://huggingface.co/usezn/Galvanize-2.
Resultados
Nuestro conjunto de prueba reservado
Nuestro conjunto de prueba reservado tiene 3.309 ejemplos en varios idiomas. Ninguno se usó en el entrenamiento. Con nuestro umbral de servicio de 0,662:
| Galvanize-60M (anterior) | Galvanize 2 | |
|---|---|---|
| Tasa de detección (recall) | 66,9 % | 83,4 % |
| Tasa de falsos positivos | 6,4 % | 0,81 % |
| AUROC | 0,899 | 0,993 |
| Documentos benignos largos marcados | ~66 % | 4,1 % |
El modelo nuevo detecta más ataques y genera aproximadamente una octava parte de las falsas alarmas.
Recall por idioma en el mismo conjunto: inglés 88 %, portugués 87 %, ruso 83 %, alemán 82 %, español 82 %, italiano 76 %.
También lo probamos con ataques nuevos que generamos internamente contra nuestro propio detector. Con 601 ejemplos nuevos, ninguno visto en el entrenamiento, Galvanize 2 detecta el 67,2 %. Estos ataques se generaron para superar a nuestro modelo anterior, así que su puntuación por debajo del 3 % es esperable por construcción. La referencia más justa es el modelo del que partimos: Horizon small, con la misma tasa de falsos positivos, detecta el 65,6 %. El alemán es el idioma más débil en ese conjunto, con alrededor del 50 %.
El benchmark público
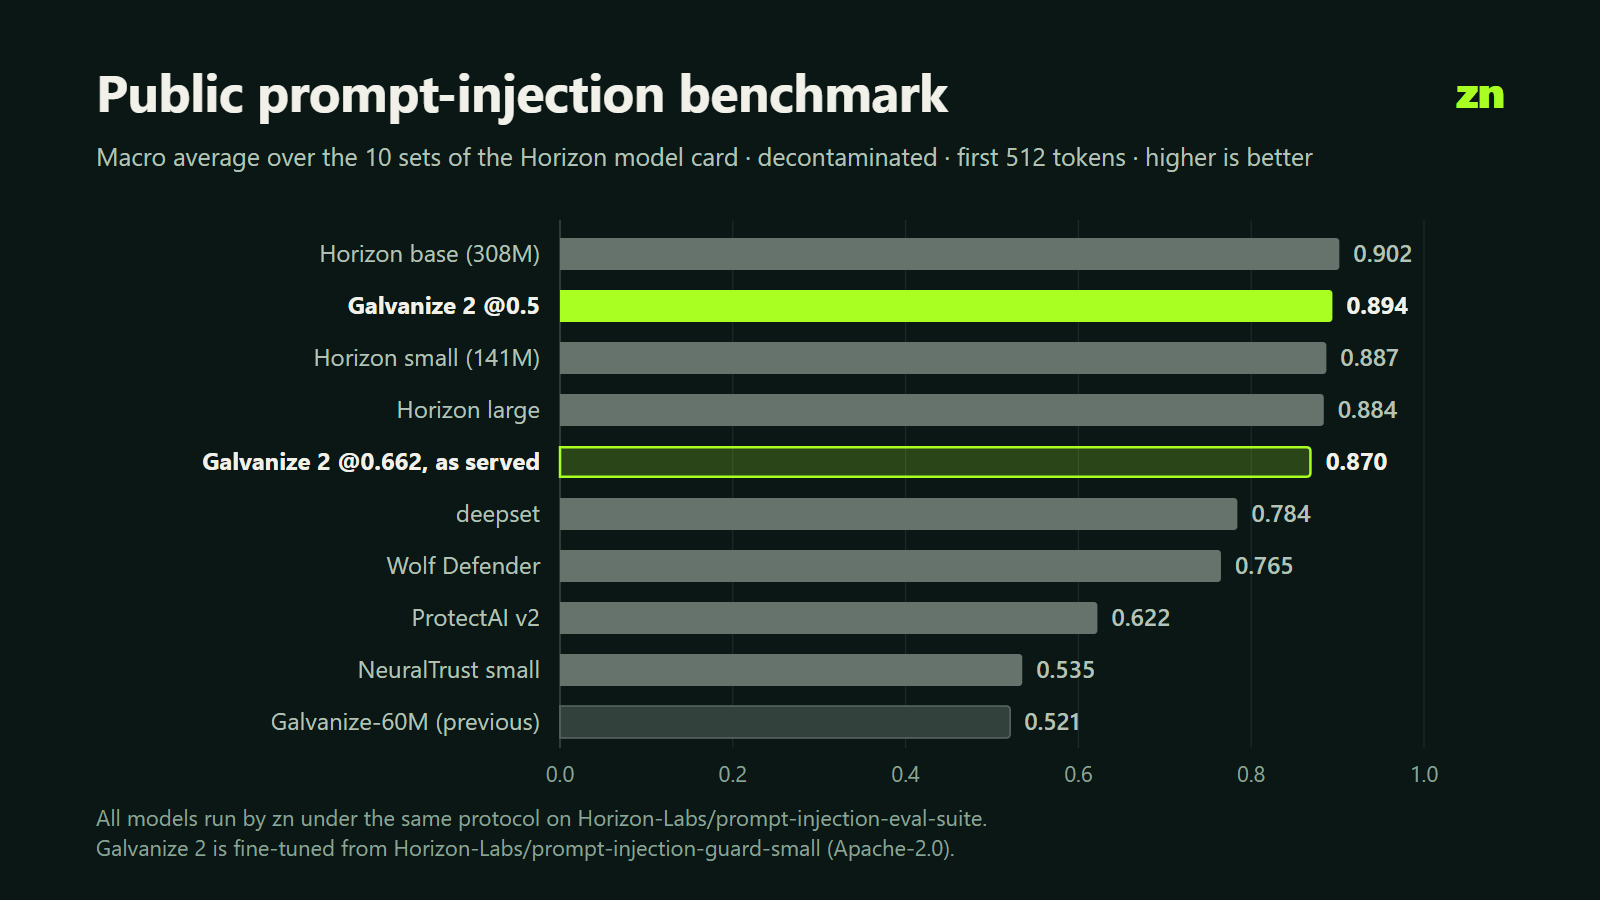
Para comparar con otros detectores abiertos, ejecutamos la Horizon-Labs/prompt-injection-eval-suite de Hugging Face. Informamos la media macro de los 10 conjuntos usados en la ficha del modelo de Horizon. Ejecutamos cada modelo nosotros mismos, con el mismo protocolo (véase "Cómo medimos").
| Modelo | Media macro |
|---|---|
| Horizon base (308 M) | 0,902 |
| Galvanize 2 (umbral 0,5) | 0,894 |
| Horizon small (141 M) | 0,887 |
| Horizon large | 0,884 |
| Galvanize 2 (umbral 0,662, como se sirve) | 0,870 |
| deepset | 0,784 |
| Wolf Defender | 0,765 |
| ProtectAI v2 | 0,622 |
| NeuralTrust small | 0,535 |
| Galvanize-60M (anterior) | 0,521 |
Galvanize 2 no es el mejor modelo en esta media: Horizon base, que es más grande, puntúa más alto. Está en el mismo rango que los detectores abiertos más sólidos que probamos, y supone un salto grande frente a nuestro modelo anterior.
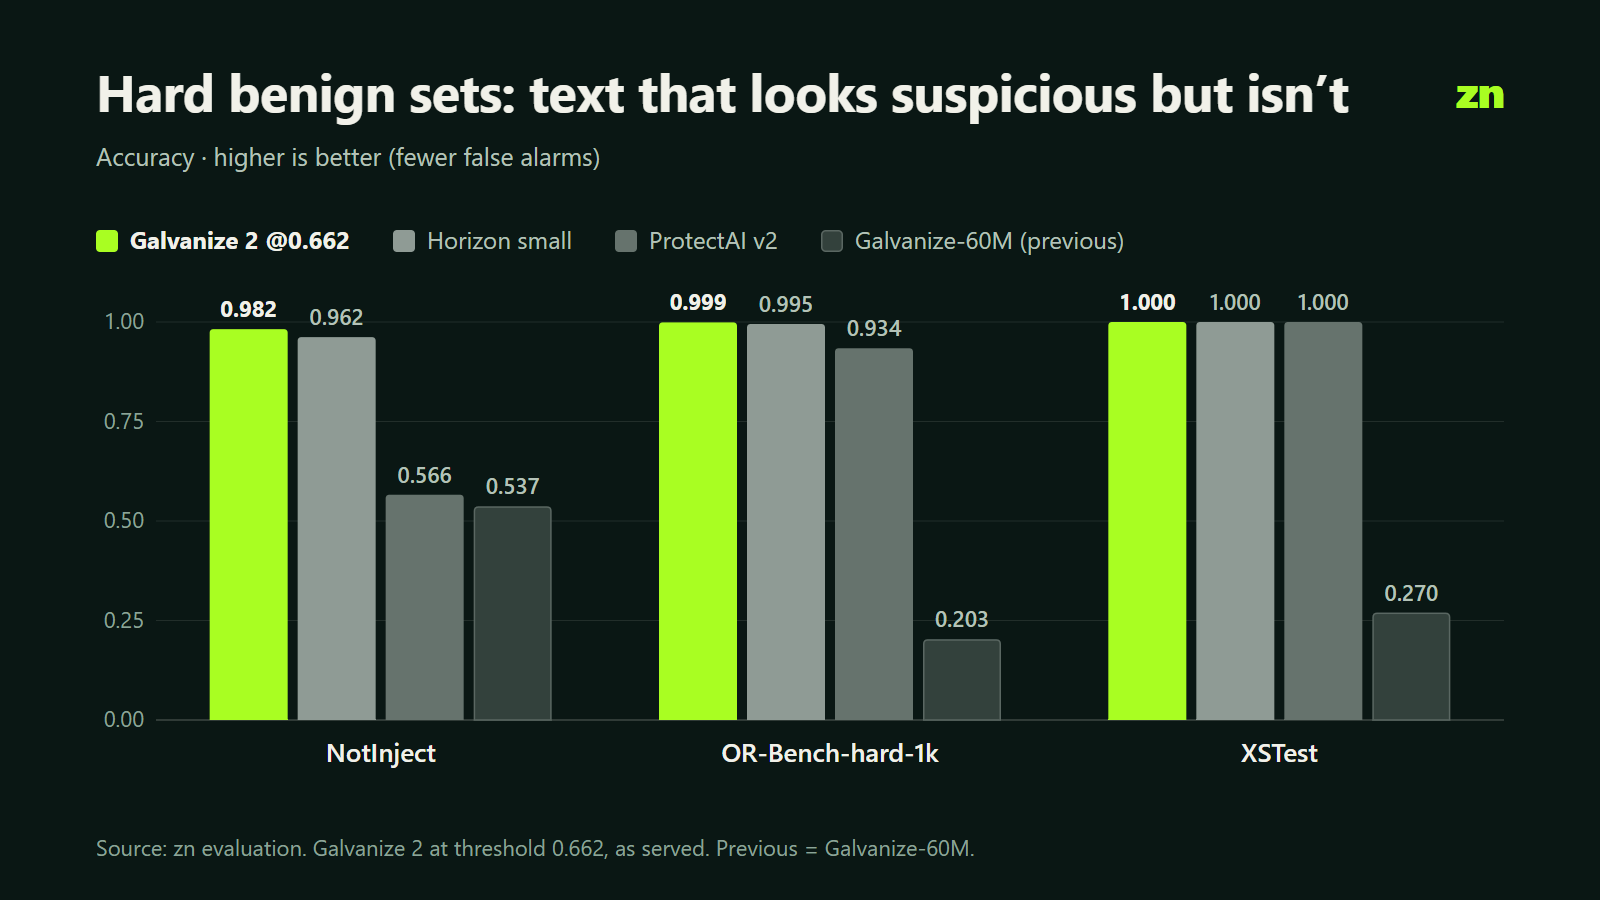
Sus mejores resultados están en los conjuntos benignos difíciles. Contienen texto que parece sospechoso pero no es un ataque: palabras disparadoras, peticiones atrevidas pero inofensivas. Exactitud con umbral 0,662; cuanto más alto, menos falsas alarmas:
| Conjunto | Galvanize-60M | Galvanize 2 |
|---|---|---|
| NotInject | 0,537 | 0,982 |
| OR-Bench-hard-1k | 0,203 | 0,999 |
| XSTest | 0,270 | 1,000 |
En NotInject y OR-Bench-hard-1k, Galvanize 2 tiene la puntuación más alta de todos los detectores de nuestra comparación.
Dónde es más débil
Con nuestro umbral de servicio de 0,662 (entre paréntesis, con 0,5):
- Conjunto de prueba de deepset: F1 0,723 (0,812). El modelo de deepset puntúa 0,992 en su propio conjunto de prueba.
- BIPIA, inyecciones ocultas en correos, tablas y código: F1 0,601 (0,670).
- Jailbreaks de Simsonsun: recall 0,741 (0,817).
Parte de la diferencia entre los dos umbrales es una decisión nuestra, explicada más abajo. Parte es real: las inyecciones camufladas en contenido estructurado, y algunos estilos de jailbreak, siguen siendo más difíciles para el modelo.
Cómo medimos
Descontaminación. Antes de puntuar, eliminamos cada fila del benchmark que coincidiera con nuestros datos de entrenamiento por hash exacto, por hash de texto normalizado o por hash de sus primeros 200 caracteres. Todos los modelos se puntuaron sobre el mismo subconjunto descontaminado. Por eso, y por el truncado que se describe a continuación, nuestras cifras de otros modelos difieren de las de sus propias fichas.
La misma entrada que en producción. El texto se aplana en espacios y se trunca a los primeros 512 tokens, exactamente como lo hace la comprobación en la nube al servir. Lo que venga después de los primeros 512 tokens no se puntúa.
Datos reservados. Nuestro conjunto de prueba reservado y nuestro conjunto de documentos largos benignos nunca se usaron en el entrenamiento.
Dos umbrales. Publicamos resultados con 0,5 y con 0,662. Servimos con 0,662, un umbral calibrado con nuestros propios datos de desarrollo. Sacrifica algo de recall para no bloquear a usuarios legítimos, porque una falsa alarma detiene un trabajo real. Si ejecutas el modelo tú mismo y un ataque no detectado te cuesta más que una falsa alarma, usa 0,5.
Servicio. Servimos el modelo en precisión completa. En un servidor de CPU de 8 hilos funciona con una mediana de unos 34 ms por petición.
El script del benchmark y los resultados completos están en el repositorio del modelo: https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark.
Qué significa para los usuarios de zn-gate
zn-gate es una capa de seguridad local y de código abierto para agentes de programación con IA (npm install zn-gate o pip install zn-gate). Los valores secretos, como claves de API, tokens y claves privadas, se eliminan en tu máquina antes de cualquier llamada a la nube, y la salida de las herramientas nunca se envía. La comprobación opcional en la nube recibe el texto de los prompts solo después de la ocultación.
Galvanize 2 está disponible hoy en Hugging Face y es ya el modelo por defecto detrás de la comprobación en la nube de zn (api.usezn.com). No tienes que cambiar nada: si tienes activada la comprobación en la nube, recibes el modelo nuevo automáticamente. Los equipos también obtienen observabilidad y un registro de auditoría de cada decisión. Hay un plan gratuito.
Qué viene después
- Alemán y otros idiomas más débiles. El alemán es el idioma más débil frente a ataques nuevos, con alrededor del 50 %, y es lo primero en lo que estamos trabajando.
- Un ciclo continuo. Cada fallo que encontremos, en nuestras pruebas o en los informes de los usuarios, se convierte en datos de entrenamiento para la siguiente versión.
- Scripts de benchmark abiertos, para que cualquiera pueda reproducir las cifras públicas de este artículo.
Enlaces
- Modelo y ficha del modelo: https://huggingface.co/usezn/Galvanize-2
- Modelo base: Horizon-Labs/prompt-injection-guard-small
- Benchmark: Horizon-Labs/prompt-injection-eval-suite · nuestros scripts: https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark
- zn-gate: github.com/usezn/zn
Si encuentras una entrada en la que Galvanize 2 se equivoca, en un sentido o en otro, escribe a security@usezn.com. Esos informes son exactamente con lo que se entrena la siguiente versión.
— John Silver
Actualizado el 14 de octubre de 2026: el texto sobre tratamiento de datos se ha reformulado para describir lo que hacen hoy el paquete y la API.