Présentation de Galvanize 2 : davantage d'attaques détectées, bien moins de fausses alertes
Mise à jour (12 oct.) : Galvanize 2 est désormais actif dans la vérification cloud de zn.
Un détecteur d'injection de prompt a deux missions. Il doit détecter les attaques, et il doit laisser tranquille tout le reste. Pour un agent d'IA, la seconde mission compte autant que la première. Les agents lisent de longs documents, des README, des journaux et des sorties d'outils toute la journée. Un détecteur qui signale un document légitime arrête l'agent au milieu d'un travail réel. Après quelques interruptions de ce type, les gens le désactivent, et il ne détecte alors plus rien.
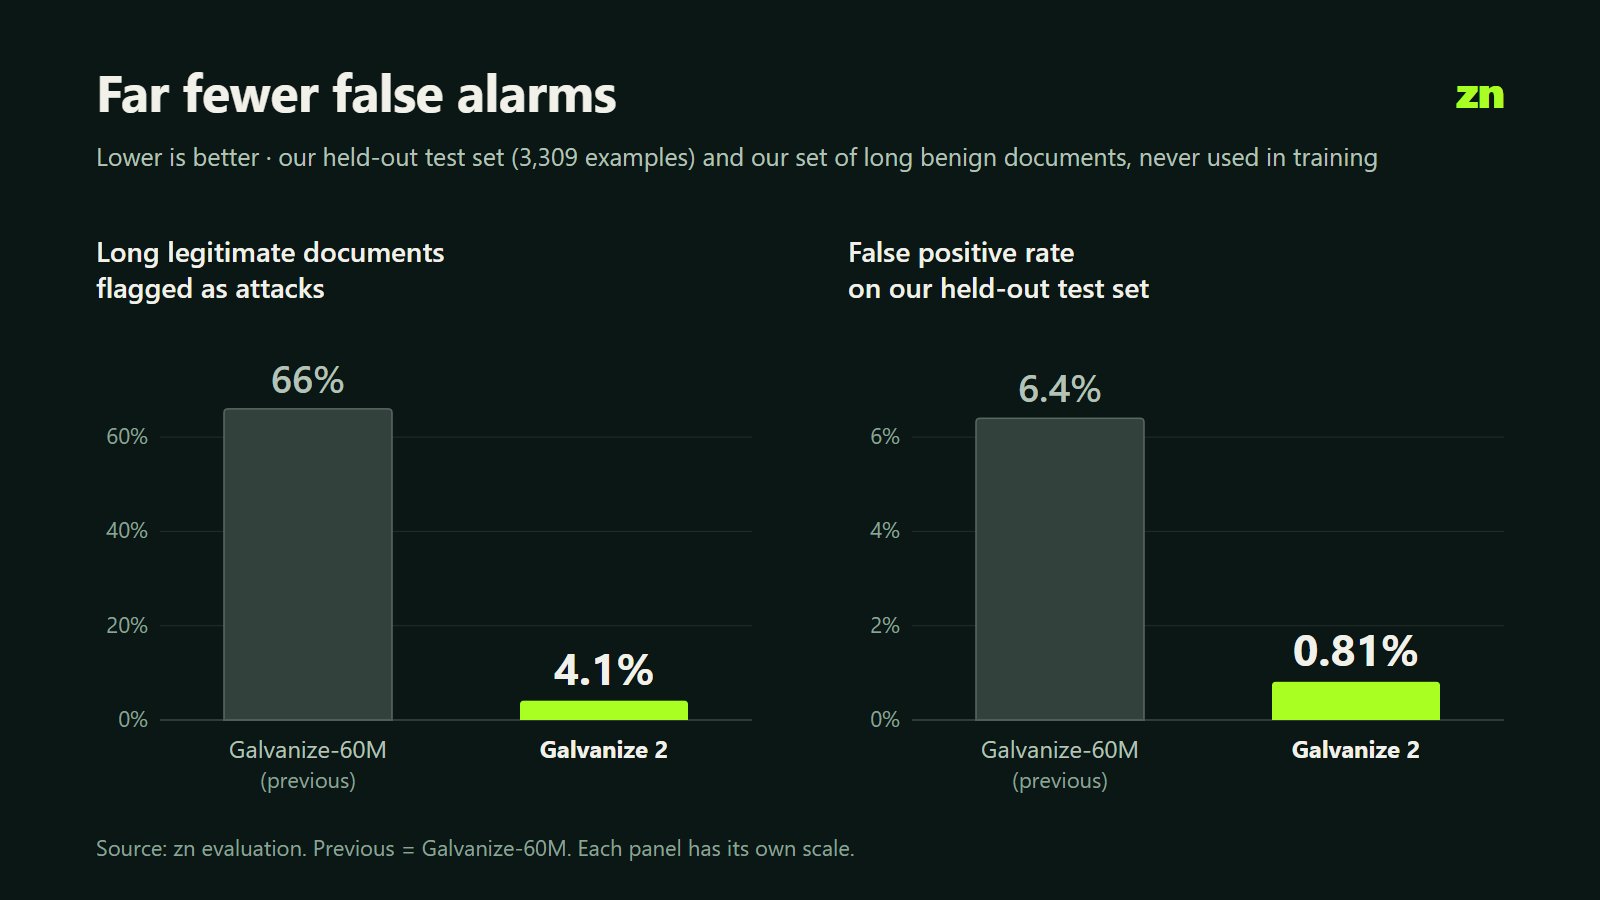
Notre modèle précédent, Galvanize-60M, a échoué à ce test. Sur notre jeu de longs documents bénins, il en a signalé environ 66 % comme des attaques. Galvanize 2 en signale 4,1 %, et il détecte aussi davantage d'attaques que le modèle qu'il remplace.
Cet article décrit ce qui a changé, les résultats (y compris les points où le modèle est plus faible), notre méthode de mesure et ce que cela implique si vous utilisez zn-gate.
Ce qui a changé
Galvanize 2 est affiné à partir de Horizon-Labs/prompt-injection-guard-small (Apache-2.0). Il compte environ 141 M de paramètres et il est multilingue. Nous sommes partis du modèle de Horizon parce que c'est déjà un détecteur ouvert solide, avec un faible taux de fausses alarmes. Nous l'avons affiné sur notre propre mélange de données publiques et internes d'injection de prompt, orienté vers ce que voient réellement les agents de programmation.
Merci à Horizon Labs d'avoir publié le modèle en open source, avec ses sources d'entraînement et sa suite d'évaluation. Galvanize 2 n'existerait pas sans ce travail.
Galvanize 2 est publié sous la même licence, Apache-2.0 : https://huggingface.co/usezn/Galvanize-2.
Résultats
Notre jeu de test réservé
Notre jeu de test réservé compte 3 309 exemples dans plusieurs langues. Aucun n'a servi à l'entraînement. Au seuil de service de 0,662 :
| Galvanize-60M (précédent) | Galvanize 2 | |
|---|---|---|
| Taux de détection (rappel) | 66,9 % | 83,4 % |
| Taux de faux positifs | 6,4 % | 0,81 % |
| AUROC | 0,899 | 0,993 |
| Longs documents bénins signalés | ~66 % | 4,1 % |
Le nouveau modèle détecte davantage d'attaques et génère environ huit fois moins de fausses alarmes.
Rappel par langue sur le même jeu : anglais 88 %, portugais 87 %, russe 83 %, allemand 82 %, espagnol 82 %, italien 76 %.
Nous le testons aussi sur de nouvelles attaques que nous générons en interne contre notre propre détecteur. Sur 601 exemples inédits, aucun vu à l'entraînement, Galvanize 2 en détecte 67,2 %. Ces attaques ont été conçues pour contourner notre modèle précédent, donc son score inférieur à 3 % est attendu par construction. La référence la plus juste est le modèle dont nous sommes partis : Horizon small, au même taux de faux positifs, détecte 65,6 %. L'allemand est la langue la plus faible sur cet ensemble, avec environ 50 %.
Le benchmark public
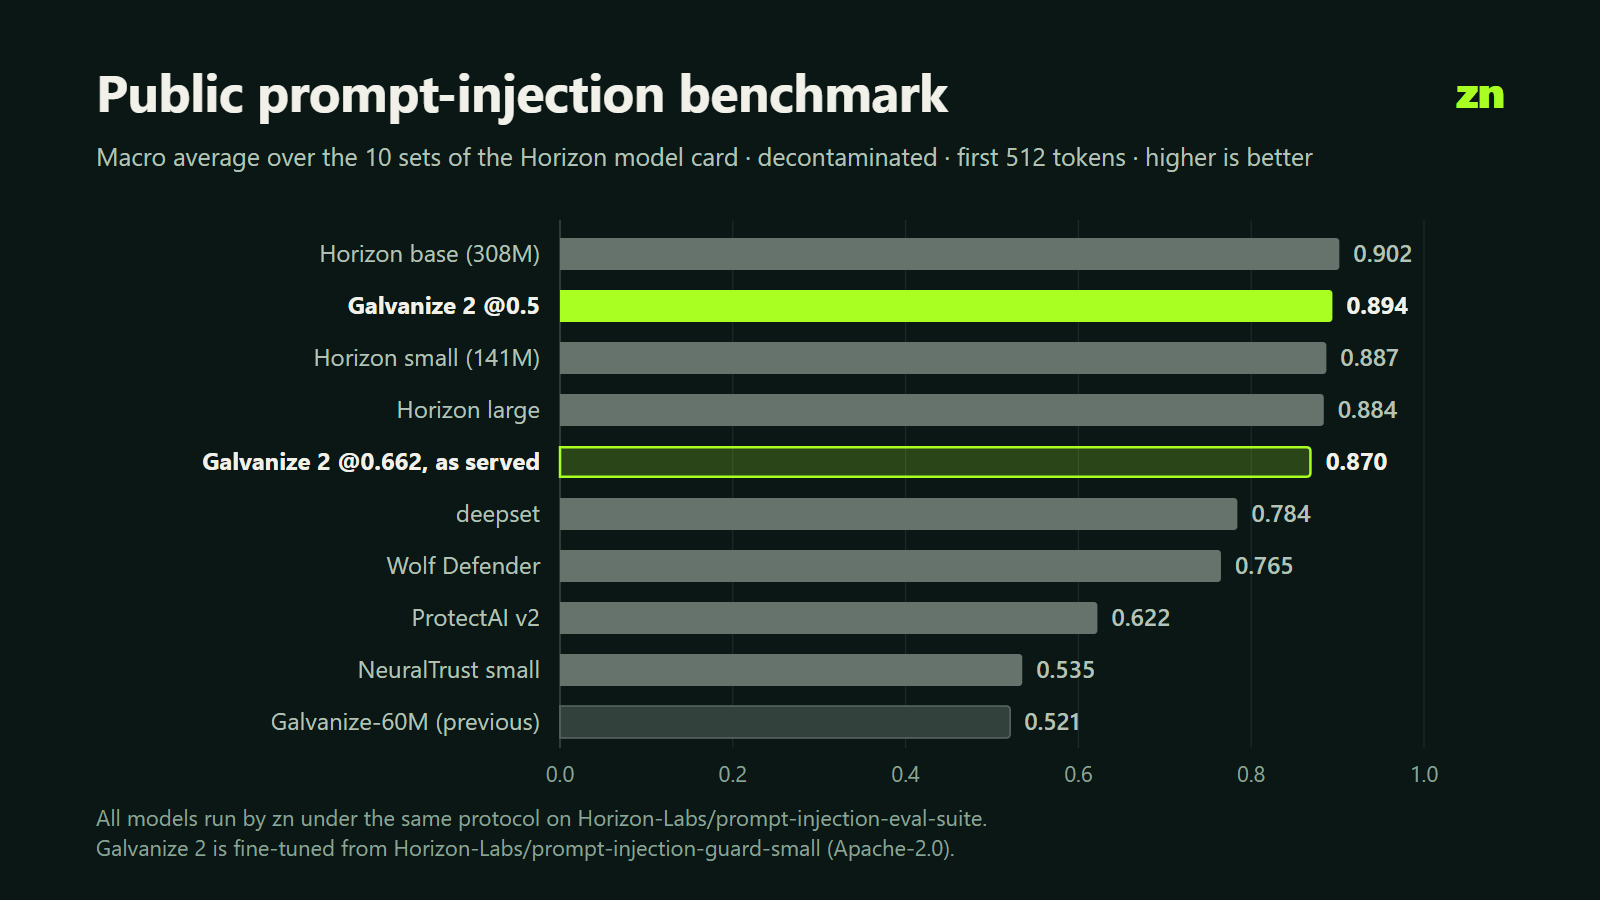
Pour comparer avec d'autres détecteurs ouverts, nous avons exécuté la Horizon-Labs/prompt-injection-eval-suite sur Hugging Face. Nous indiquons la moyenne macro sur les 10 jeux utilisés dans la fiche du modèle Horizon. Nous avons exécuté chaque modèle nous-mêmes, selon le même protocole (voir « Comment nous avons mesuré »).
| Modèle | Moyenne macro |
|---|---|
| Horizon base (308 M) | 0,902 |
| Galvanize 2 (seuil 0,5) | 0,894 |
| Horizon small (141 M) | 0,887 |
| Horizon large | 0,884 |
| Galvanize 2 (seuil 0,662, tel que servi) | 0,870 |
| deepset | 0,784 |
| Wolf Defender | 0,765 |
| ProtectAI v2 | 0,622 |
| NeuralTrust small | 0,535 |
| Galvanize-60M (précédent) | 0,521 |
Galvanize 2 n'est pas le meilleur modèle sur cette moyenne : Horizon base, plus grand, obtient un score supérieur. Il se situe dans la même fourchette que les détecteurs ouverts les plus solides que nous ayons testés, et représente un progrès net par rapport à notre modèle précédent.
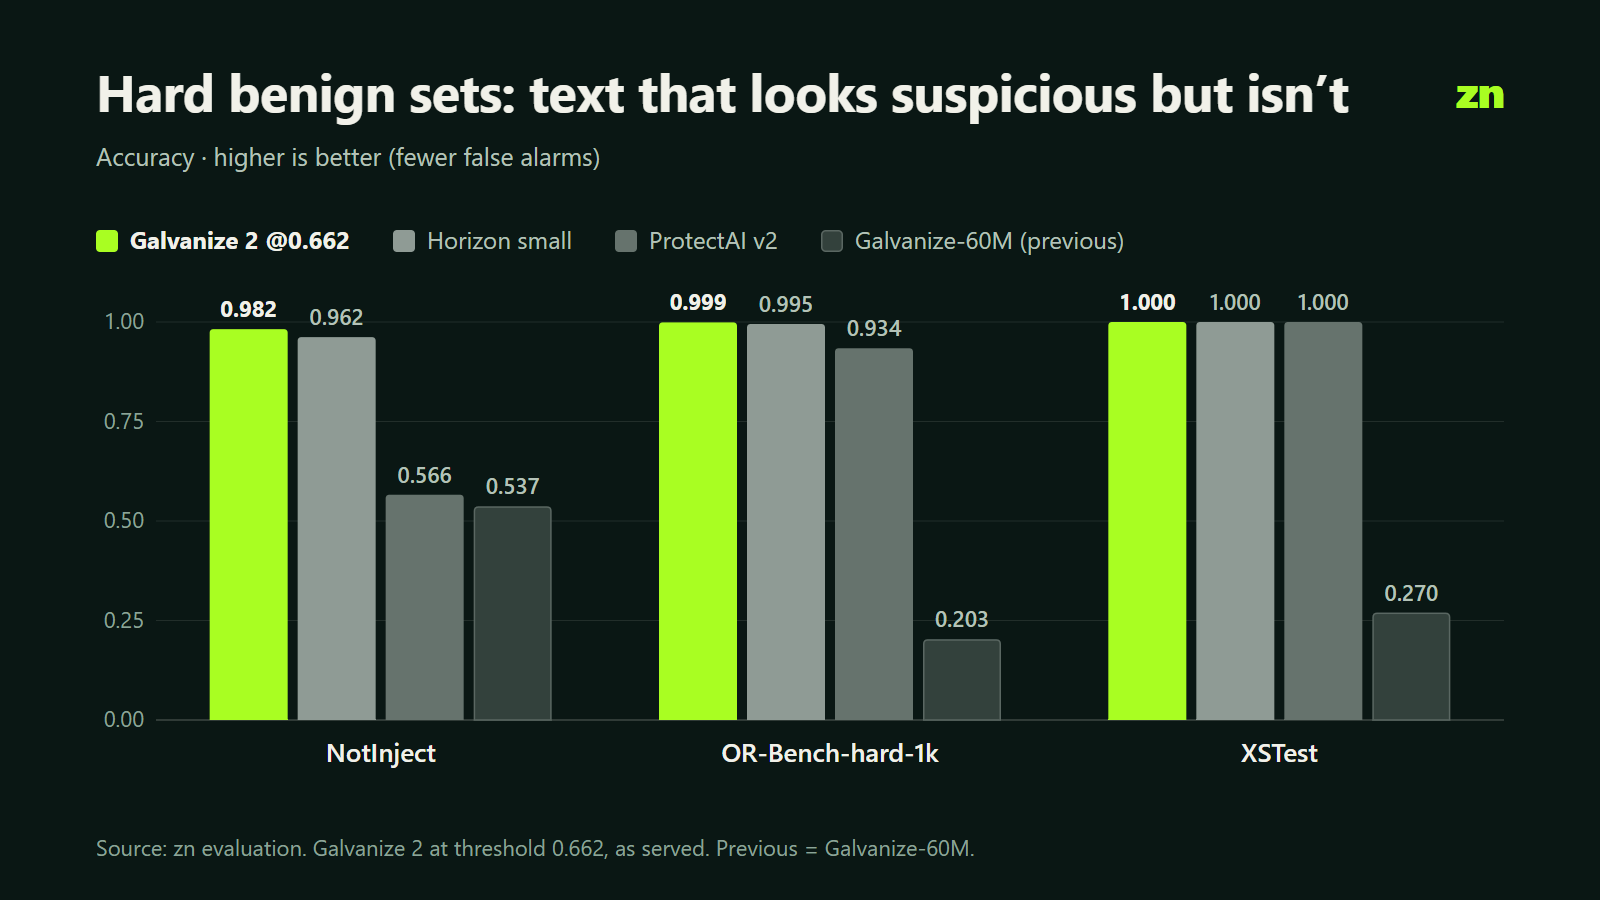
Ses meilleurs résultats concernent les jeux bénins difficiles. Ils contiennent des textes d'apparence suspecte mais qui ne sont pas des attaques : mots déclencheurs, demandes audacieuses mais inoffensives. Exactitude au seuil 0,662 ; plus la valeur est élevée, moins il y a de fausses alarmes :
| Jeu | Galvanize-60M | Galvanize 2 |
|---|---|---|
| NotInject | 0,537 | 0,982 |
| OR-Bench-hard-1k | 0,203 | 0,999 |
| XSTest | 0,270 | 1,000 |
Sur NotInject et OR-Bench-hard-1k, Galvanize 2 obtient le score le plus élevé de tous les détecteurs de notre comparaison.
Là où il est plus faible
Au seuil de service de 0,662 (avec 0,5 entre parenthèses) :
- Jeu de test deepset : F1 0,723 (0,812). Le modèle de deepset obtient 0,992 sur son propre jeu de test.
- BIPIA, injections dissimulées dans des e-mails, des tableaux et du code : F1 0,601 (0,670).
- Jailbreaks de Simsonsun : rappel 0,741 (0,817).
Une partie de l'écart entre les deux seuils est un choix de notre part, expliqué plus bas. Une autre partie est réelle : les injections cachées dans des contenus structurés, et certains styles de jailbreak, restent plus difficiles pour le modèle.
Comment nous avons mesuré
Décontamination. Avant le scoring, nous avons retiré chaque ligne de benchmark correspondant à nos données d'entraînement, par hachage exact, par hachage du texte normalisé ou par hachage de ses 200 premiers caractères. Tous les modèles ont été évalués sur le même sous-ensemble décontaminé. Pour cette raison, et à cause de la troncature décrite ci-dessous, nos chiffres pour les autres modèles diffèrent de ceux de leurs propres fiches.
La même entrée qu'en production. Le texte est aplati en espaces et tronqué aux 512 premiers tokens, exactement comme le fait la vérification cloud en service. Ce qui suit les 512 premiers tokens n'est pas évalué.
Données réservées. Notre jeu de test réservé et notre jeu de longs documents bénins n'ont jamais servi à l'entraînement.
Deux seuils. Nous publions les résultats à 0,5 et à 0,662. Nous servons à 0,662, un seuil calibré sur nos propres données de développement. Il sacrifie un peu de rappel pour éviter de bloquer des utilisateurs légitimes, car une fausse alarme interrompt un travail réel. Si vous exécutez le modèle vous-même et qu'une attaque manquée vous coûte plus qu'une fausse alarme, utilisez 0,5.
Service. Nous servons le modèle en pleine précision. Sur un serveur CPU à 8 threads, il tourne avec une médiane d'environ 34 ms par requête.
Le script de benchmark et les résultats complets se trouvent dans le dépôt du modèle : https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark.
Ce que cela change pour les utilisateurs de zn-gate
zn-gate est une couche de sécurité locale et open source pour les agents de programmation IA (npm install zn-gate ou pip install zn-gate). Les valeurs secrètes, comme les clés d'API, les jetons et les clés privées, sont supprimées sur votre machine avant tout appel cloud, et la sortie des outils n'est jamais envoyée. La vérification cloud optionnelle ne reçoit le texte des prompts qu'après caviardage.
Galvanize 2 est disponible aujourd'hui sur Hugging Face et constitue désormais le modèle par défaut derrière la vérification cloud de zn (api.usezn.com). Vous n'avez rien à modifier : si la vérification cloud est activée, vous recevez automatiquement le nouveau modèle. Les équipes bénéficient aussi d'une observabilité et d'une piste d'audit de chaque décision. Il existe une offre gratuite.
Et ensuite
- L'allemand et les autres langues plus faibles. L'allemand est la langue la plus faible face aux nouvelles attaques, avec environ 50 %, et c'est le premier sujet sur lequel nous travaillons.
- Une boucle continue. Chaque erreur que nous trouvons, lors de nos propres tests ou via les signalements des utilisateurs, devient une donnée d'entraînement pour la version suivante.
- Des scripts de benchmark ouverts, pour que chacun puisse reproduire les chiffres publics de cet article.
Liens
- Modèle et fiche du modèle : https://huggingface.co/usezn/Galvanize-2
- Modèle de base : Horizon-Labs/prompt-injection-guard-small
- Benchmark : Horizon-Labs/prompt-injection-eval-suite · nos scripts : https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark
- zn-gate : github.com/usezn/zn
Si vous trouvez une entrée pour laquelle Galvanize 2 se trompe, dans un sens ou dans l'autre, écrivez à security@usezn.com. Ces signalements sont exactement ce sur quoi la version suivante est entraînée.
— John Silver
Mis à jour le 14 octobre 2026 : la formulation sur le traitement des données a été reformulée pour décrire ce que font aujourd'hui le paquet et l'API.