Apresentamos o Galvanize 2: mais ataques detetados, muito menos alarmes falsos
Atualização (12 out.): o Galvanize 2 já está ativo na verificação cloud da zn.
Um detetor de injeção de prompts tem duas funções. Tem de detetar ataques e tem de deixar em paz tudo o resto. Para um agente de IA, a segunda função importa tanto como a primeira. Os agentes lêem documentos longos, READMEs, registos e saídas de ferramentas o dia inteiro. Um detetor que sinaliza um documento legítimo pára o agente a meio de um trabalho real. Depois de algumas dessas paragens, as pessoas desligam-no, e então já não deteta nada.
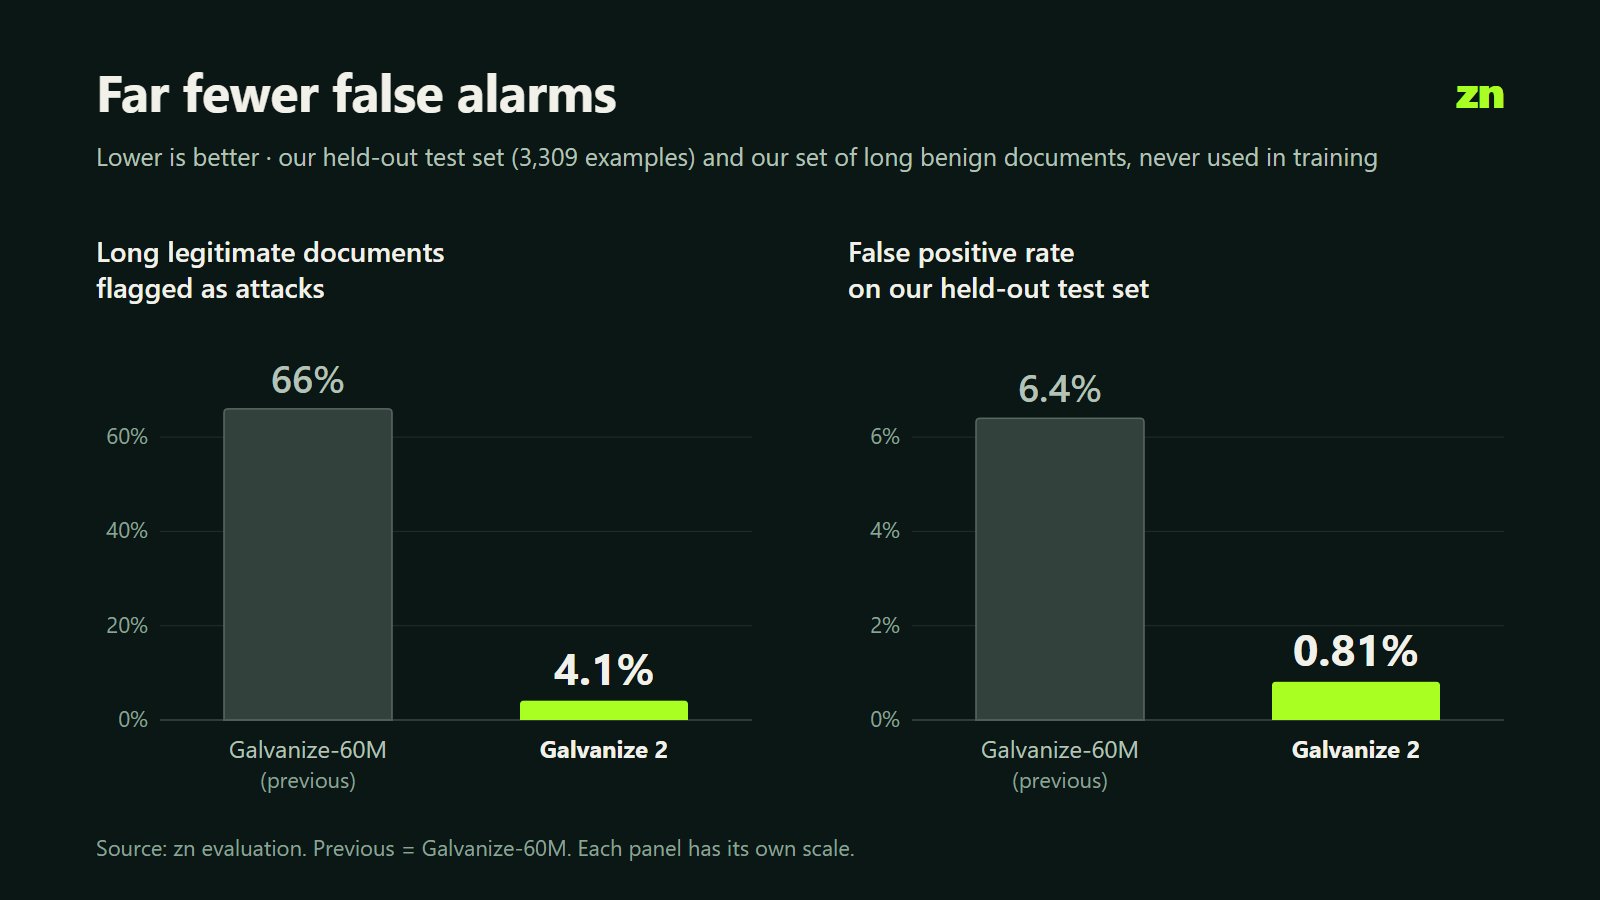
O nosso modelo anterior, o Galvanize-60M, chumbou nesse teste. No nosso conjunto de documentos longos benignos, sinalizou cerca de 66% deles como ataques. O Galvanize 2 sinaliza 4,1%, e além disso deteta mais ataques do que o modelo que substitui.
Este artigo descreve o que mudou, os resultados (incluindo onde o modelo é mais fraco), como medimos e o que isto significa se usar o zn-gate.
O que mudou
O Galvanize 2 é ajustado a partir do Horizon-Labs/prompt-injection-guard-small (Apache-2.0). Tem cerca de 141 M de parâmetros e é multilingue. Partimos do modelo da Horizon porque já é um detetor aberto sólido, com uma taxa baixa de alarmes falsos. Ajustámo-lo com a nossa própria mistura de dados públicos e internos de injeção de prompts, orientada para o que os agentes de programação realmente veem.
Obrigado à Horizon Labs por publicar o modelo em aberto, com as suas fontes de treino e a sua suíte de avaliação. O Galvanize 2 não existiria sem esse trabalho.
O Galvanize 2 é publicado com a mesma licença, Apache-2.0: https://huggingface.co/usezn/Galvanize-2.
Resultados
O nosso conjunto de teste reservado
O nosso conjunto de teste reservado tem 3.309 exemplos em várias línguas. Nenhum foi usado no treino. Com o nosso limiar de serviço de 0,662:
| Galvanize-60M (anterior) | Galvanize 2 | |
|---|---|---|
| Taxa de deteção (recall) | 66,9% | 83,4% |
| Taxa de falsos positivos | 6,4% | 0,81% |
| AUROC | 0,899 | 0,993 |
| Documentos benignos longos sinalizados | ~66% | 4,1% |
O modelo novo deteta mais ataques e gera cerca de um oitavo dos alarmes falsos.
Recall por língua no mesmo conjunto: inglês 88%, português 87%, russo 83%, alemão 82%, espanhol 82%, italiano 76%.
Também o testámos contra ataques novos que geramos internamente contra o nosso próprio detetor. Em 601 exemplos novos, nenhum visto no treino, o Galvanize 2 deteta 67,2%. Estes ataques foram gerados para passar pelo nosso modelo anterior, por isso a sua pontuação abaixo de 3% é esperada por construção. A referência mais justa é o modelo de onde partimos: o Horizon small, com a mesma taxa de falsos positivos, deteta 65,6%. O alemão é a língua mais fraca nesse conjunto, com cerca de 50%.
O benchmark público
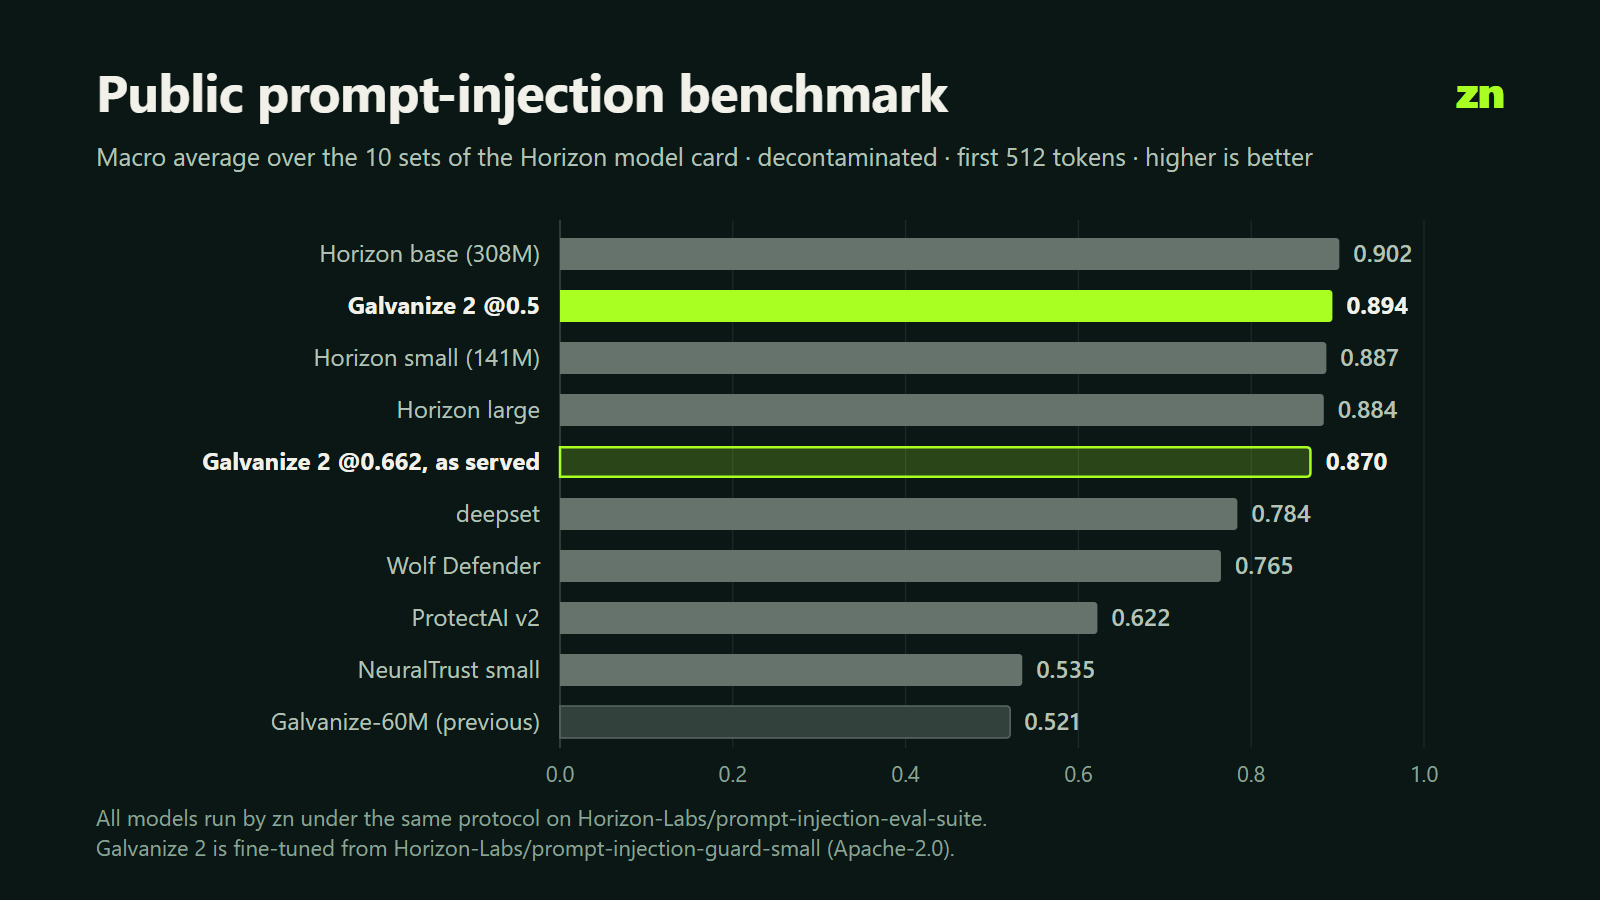
Para comparar com outros detetores abertos, corremos a Horizon-Labs/prompt-injection-eval-suite no Hugging Face. Reportamos a média macro dos 10 conjuntos usados na ficha do modelo Horizon. Corremos cada modelo nós próprios, com o mesmo protocolo (ver "Como medimos").
| Modelo | Média macro |
|---|---|
| Horizon base (308 M) | 0,902 |
| Galvanize 2 (limiar 0,5) | 0,894 |
| Horizon small (141 M) | 0,887 |
| Horizon large | 0,884 |
| Galvanize 2 (limiar 0,662, como servido) | 0,870 |
| deepset | 0,784 |
| Wolf Defender | 0,765 |
| ProtectAI v2 | 0,622 |
| NeuralTrust small | 0,535 |
| Galvanize-60M (anterior) | 0,521 |
O Galvanize 2 não é o modelo melhor classificado nesta média: o Horizon base, maior, pontua mais alto. Está na mesma faixa dos detetores abertos mais fortes que testámos, e representa um salto grande face ao nosso modelo anterior.
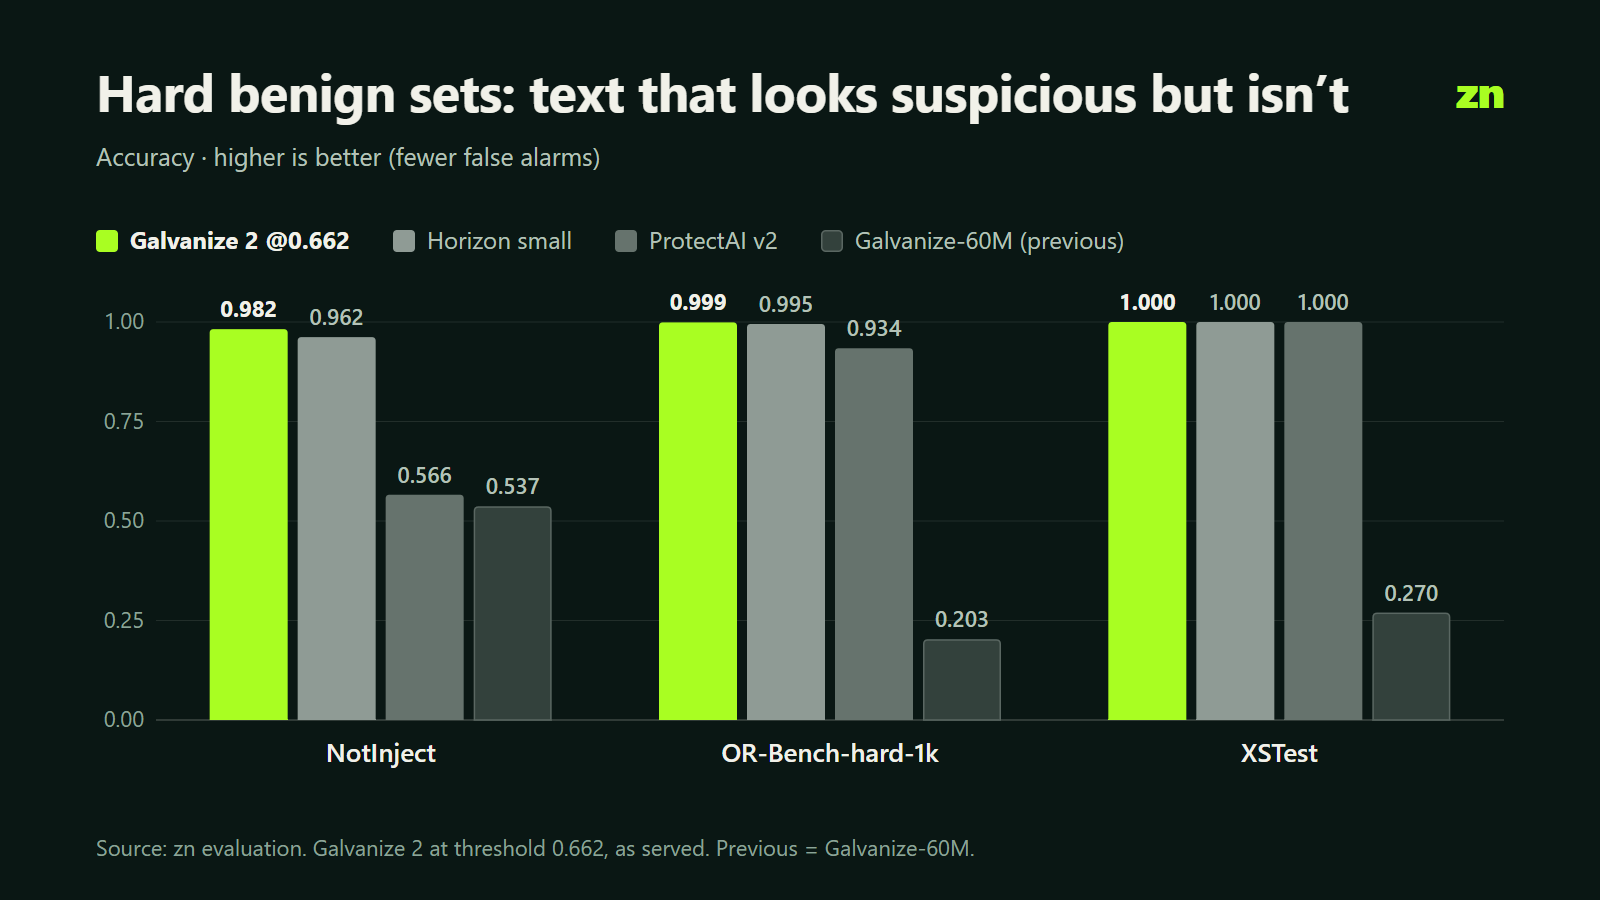
Os resultados mais fortes estão nos conjuntos benignos difíceis. Estes contêm texto que parece suspeito mas não é um ataque: palavras-gatilho, pedidos ousados mas inofensivos. Exatidão com limiar 0,662; quanto mais alto, menos alarmes falsos:
| Conjunto | Galvanize-60M | Galvanize 2 |
|---|---|---|
| NotInject | 0,537 | 0,982 |
| OR-Bench-hard-1k | 0,203 | 0,999 |
| XSTest | 0,270 | 1,000 |
No NotInject e no OR-Bench-hard-1k, o Galvanize 2 tem a pontuação mais alta de todos os detetores da nossa comparação.
Onde é mais fraco
Com o nosso limiar de serviço de 0,662 (com 0,5 entre parênteses):
- Conjunto de teste da deepset: F1 0,723 (0,812). O modelo da deepset pontua 0,992 no seu próprio conjunto de teste.
- BIPIA, injeções escondidas em emails, tabelas e código: F1 0,601 (0,670).
- Jailbreaks da Simsonsun: recall 0,741 (0,817).
Parte da diferença entre os dois limiares é uma escolha nossa, explicada abaixo. Parte é real: as injeções colocadas em conteúdo estruturado, e alguns estilos de jailbreak, continuam a ser mais difíceis para o modelo.
Como medimos
Descontaminação. Antes de pontuar, removemos cada linha do benchmark que coincidisse com os nossos dados de treino por hash exato, por hash do texto normalizado ou por hash dos seus primeiros 200 caracteres. Todos os modelos foram pontuados no mesmo subconjunto descontaminado. Por isso, e pelo truncamento descrito abaixo, os nossos números para outros modelos diferem dos que aparecem nas respetivas fichas.
A mesma entrada que em produção. O texto é achatado em espaços e truncado aos primeiros 512 tokens, exatamente como a verificação cloud faz ao servir. Tudo o que vem depois dos primeiros 512 tokens não é pontuado.
Dados reservados. O nosso conjunto de teste reservado e o nosso conjunto de documentos longos benignos nunca foram usados no treino.
Dois limiares. Publicamos resultados a 0,5 e a 0,662. Servimos a 0,662, um limiar calibrado nos nossos próprios dados de desenvolvimento. Abdica de algum recall para não bloquear utilizadores legítimos, porque um alarme falso interrompe trabalho real. Se correr o modelo você mesmo e um ataque não detetado lhe custar mais do que um alarme falso, use 0,5.
Serviço. Servimos o modelo em precisão total. Num servidor de CPU com 8 threads, corre com uma mediana de cerca de 34 ms por pedido.
O script do benchmark e os resultados completos estão no repositório do modelo: https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark.
O que significa para utilizadores do zn-gate
O zn-gate é uma camada de segurança local e de código aberto para agentes de programação com IA (npm install zn-gate ou pip install zn-gate). Valores secretos, como chaves de API, tokens e chaves privadas, são removidos na sua máquina antes de qualquer chamada à cloud, e a saída das ferramentas nunca é enviada. A verificação cloud opcional recebe o texto dos prompts apenas depois da redação.
O Galvanize 2 está disponível hoje no Hugging Face e é agora o modelo por defeito por trás da verificação cloud da zn (api.usezn.com). Não precisa de alterar nada: se tiver a verificação cloud ativada, recebe o novo modelo automaticamente. As equipas também obtêm observabilidade e um registo de cada decisão. Existe um plano gratuito.
O que se segue
- Alemão e as outras línguas mais fracas. O alemão é a língua mais fraca em ataques novos, com cerca de 50%, e é a primeira coisa em que estamos a trabalhar.
- Um ciclo contínuo. Cada falha que encontrarmos, nos nossos testes ou nos relatos dos utilizadores, torna-se dados de treino para a versão seguinte.
- Scripts de benchmark abertos, para que qualquer pessoa possa reproduzir os números públicos deste artigo.
Ligações
- Modelo e ficha do modelo: https://huggingface.co/usezn/Galvanize-2
- Modelo base: Horizon-Labs/prompt-injection-guard-small
- Benchmark: Horizon-Labs/prompt-injection-eval-suite · os nossos scripts: https://huggingface.co/usezn/Galvanize-2/tree/main/benchmark
- zn-gate: github.com/usezn/zn
Se encontrar um input em que o Galvanize 2 se engana, num sentido ou noutro, escreva para security@usezn.com. Esses relatos são exatamente aquilo em que a versão seguinte é treinada.
— John Silver
Atualizado a 14 de outubro de 2026: a redação sobre o tratamento de dados foi revista para descrever o que o pacote e a API fazem hoje.